动效方案对比
一、先掰清楚术语(这里最容易混)#
"用 sprite 做动画"这句话在中文里指两件完全不同的事:
| 说法 | 实际指的东西 | 一句话 |
|---|---|---|
| 序列帧动画(sprite sheet / 帧动画) | 每一帧都是一张完整的图,逐帧播放 | 像翻页动画书 |
| 拆件动画(cutout / 纸片 / 骨骼动画) | 角色拆成零件,靠骨骼驱动零件运动 | 像皮影戏 |
你说的"拆解出来做动画"是第二种。而"sprite 动画"这个词通常指第一种。 两者经常被拿来对比,但它们其实不在同一个维度上——第三节会说明为什么。
序列帧存的是结果(每一帧长什么样);拆件存的是零件 + 运动规则(怎么动)。
二、三个方案#
| A. 序列帧(手绘/美术出图) | B. 拆件(骨骼) | C. 生图序列帧 | |
|---|---|---|---|
| 存什么 | 每帧一张完整图 | 零件各一张 + 骨骼参数 | 每帧一张完整图 |
| 表现力上限 | 最高(能画出任何形变、透视、特效) | 中高(零件是刚体,不能自由形变) | 低 |
| 体积 | 帧数 × 每帧大小 | 零件只存一次 | 帧数 × 每帧大小 |
| 改一个动作 | 重画所有帧 | 改参数就行 | 重新生图 |
| 换皮复用 | 整套重画 | 换零件,骨架不动 | 整套重生 |
| 关节穿帮 | 无(本来就是画好的) | 有(关节处要藏) | 无 |
| 运行期开销 | 低(1 次绘制/个) | 高(N 个零件 = N 次变换 + N 次绘制) | 低 |
| 代表工具/案例 | 街机、像素游戏、2D 格斗 | Spine / DragonBones / Live2D、大部分手游 | — |
业界关于这两者的取舍讨论很多,可参考 frame-by-frame vs skeleton 的对比帖 与 Spine 还是帧动画的中文讨论。
三、本项目实测#
3.1 方案 C 已经被否决#
| 指标 | 实测 | 结论 |
|---|---|---|
| 帧间位置漂移 | 48 × 86 px | 修不了 |
| 帧间形变 | 鸡冠、翅膀每帧形状都在变 | 修不了(模型理解"走路循环",不理解"角色必须是同一个") |
| 帧数 | 6 帧 | 做不出细节 |
详见 docs/动效验证-序列帧.md 第一节。
3.2 方案 B 已经在用,但天花板被原图锁住了#
小鸡现在是 4 个零件。量了一下哪些像素能独立运动:
| 零件 | 像素 | 占整体 | 能不能独立动 |
|---|---|---|---|
| head | 23145 | 48.9% | 能 |
| body | 27791 | 58.7% | 主体,只能整体平移 / 旋转 / 缩放 |
| footL | 2813 | 5.9% | 能 |
| footR | 1682 | 3.6% | 能 |
可独立运动的像素合计 58.4%。
剩下 41.6% 是一整块刚体。而且 head 是横切下来的——原图里这只小鸡是"一坨"(头身连在一起), 没有脖子,只能在 52% 高度横着切一刀。
这只小鸡能拆出 4 块,是因为它只有 4 个可分离的部分。 换成一只四肢分明的角色(比如小羊),同样的代码能拆出 8~10 块,动画质量完全不是一个量级。
想让动画好,先让美术把角色画成可拆的。
3.3 体积与运行期开销(这是最关键的一组数)#
以 30 只动物同屏为例(docs/核心玩法.md 里那个待解决问题):
| 素材体积(磁盘) | 纹理内存(RGBA) | 每帧顶点数 | |
|---|---|---|---|
| 拆件(4 种动物 × 各 4 张全尺寸零件) | 698 KB | 1.58 MB | 24n |
| 烘焙成序列帧(按 300px 高) | 410 KB | 2.14 MB | 6n |
| 烘焙成序列帧(按实际显示尺寸 48px) | 10 KB | 540 KB | 6n |
烘焙按实际尺寸出图后,纹理内存小 2.9 倍,磁盘体积小 70 倍(压缩算法对小图更友好)。
序列帧的体积随显示尺寸平方缩放。按 300px 出的图拿去显示 48px,白白浪费 39 倍体积。 按实际尺寸烘焙,4 种动物一共只要 10 KB。
[!warning] 但"零件多 = draw call 多"是错的 这只在没有合批的时候成立。真实 2D 引擎(Cocos / Laya)会按纹理合批: 同一张图集上的所有四边形被合并成一次 draw call。 所以零件多的真正代价落在顶点数上,不是 draw call 上——第六节有实测。
四、结论:这两个方案不是二选一#
它们不在同一个维度上——一个是制作方式,一个是运行方式:
制作期:拆件(骨骼)
   │  可调、体积小、改一个动作不用重画
   │  策划说"摆幅再大点"→ 改个数字,立刻看效果
   ▼
烘焙(离线把每一帧渲染成图)
   │
   ▼
运行期:按屏幕上同时有几个来定
   ├─ 少数大角色(主界面那只)  → 直接跑骨骼,反正就几个
   └─ 大量小角色(田里 30 只)  → 用烘焙好的序列帧,1 次绘制/只
这才是答案。 拆件负责"好做、好改",序列帧负责"好渲染、体积小"。 两边各拿自己最擅长的那一半。
因为方案 C 的失败原因不是"用了序列帧",而是"用生图来出帧"。 序列帧本身没问题——从拆件烘焙出来的序列帧,帧间是绝对一致的 (同一个骨架、同一套零件、同一组参数算出来的),漂移为 0。
五、给美术的硬要求:角色要"画成可拆的"#
这是这一节里唯一需要改变出图方式的地方。
现在这样(不好拆)#
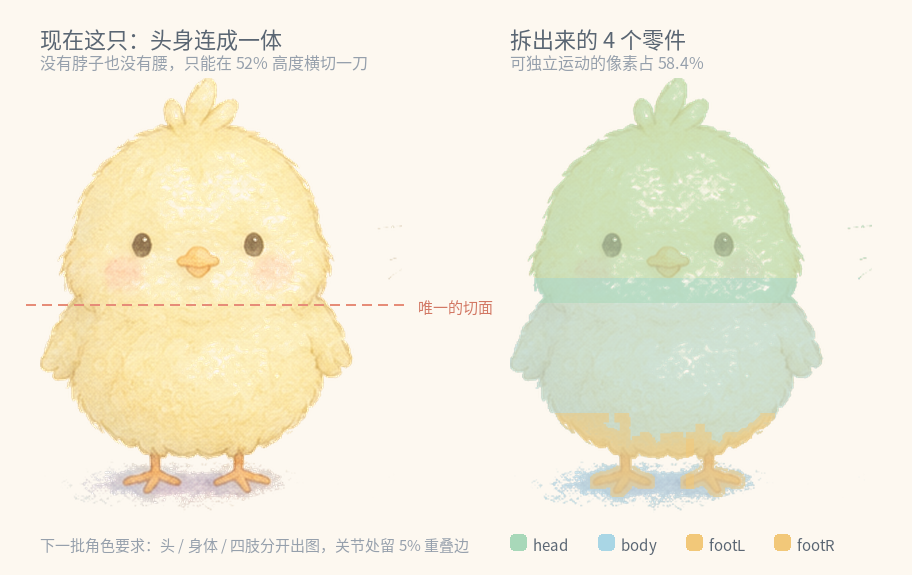
头身连成"一坨",没有脖子、没有腰,只能在 52% 高度横着切一刀。 切面落在纯色区域才看不出来,所以只能切一层。
下一批应该这样#
| 要求 | 为什么 |
|---|---|
| 头 / 身体 / 四肢分开出图,不要连成一体 | 连成一体就只能横切,可动部分不到 60% |
| 每个零件多画 5% 的重叠边 | 关节转动时不会露出缝(脚就是靠这个藏住的) |
| 关节处别放关键细节(眼睛、花纹、logo) | 转起来会被重叠边盖住 |
| 零件画在同一个坐标系里,出图带位置信息 | rig 才知道每个零件该摆哪;静止姿势才能和原图一致 |
| 每个零件的轴心位置标注出来(脖子、肩、髋) | 轴心错了,转起来就是错位 |
角色形象是已经定稿的资产。"再生成一版零件"看着省事,实际是偷偷换了角色—— 实测把原版的正面小鸡(两只眼睛、喙在正中)换成了侧面的(一只眼睛、喙偏在一侧)。
正确做法见 tools/art/cut_chick.py:拿原图切,切完必须能原样拼回去,
和原图做像素差——现在是 0.00%。
六、同屏几十个相同物体:实测#
这一节回答那个具体问题:屏幕上几十只一模一样的动物同时播放动画,哪个方案更快?
"相同"这个词是关键——它意味着所有实例共享同一份素材,于是可以合批、可以实例化。 如果是几十个各不相同的角色,下面的结论全部作废。
7.1 测试条件#
- 场景:430×764 竖屏(手机尺寸),每只按 48px 高显示,16 帧循环、相位错开
- 三个数量:30 / 60 / 120 只
- 每帧结束强制同步一次(
readPixels)——不这么做量到的只是"录命令"的时间,不是真正的光栅化 - 素材:
docs/art/anim/下的零件图与烘焙序列帧,脚本在tools/art/bench/(跑法见该目录的 README)
7.2 结果(ms/帧,越低越好)#
| 渲染方式 | 30 只 | 60 只 | 120 只 |
|---|---|---|---|
| Canvas 2D · 拆件(4 次 drawImage/只) | 1.55 | 2.97 | 6.02 |
| Canvas 2D · 序列帧(1 次/只) | 0.32 | 0.57 | 1.56 |
| WebGL · 拆件(每零件一次 drawArrays) | 3.14 | 5.58 | 10.58 |
| WebGL · 序列帧(每只一次 drawArrays) | 0.79 | 1.25 | 2.09 |
| WebGL · 合批 · 拆件(全部合成 1 次 draw call) | 0.62 | 0.58 | 0.89 |
| WebGL · 合批 · 序列帧(全部合成 1 次 draw call) | 0.43 | 0.40 | 0.45 |
7.3 三个结论#
① 合批与否,差了一个数量级
同样 120 只:
WebGL 不合批 · 拆件   10.58 ms   ← 每只每个零件都单独一次 drawArrays
WebGL 合批  · 拆件    0.89 ms   ← 全部四边形拼成一个顶点缓冲,只发一次
                      ↑ 差 12 倍
"零件多 = draw call 多"这个直觉只在没有合批的时候成立。 真实 2D 引擎(Cocos / Laya / Egret)都会按纹理合批,所以这条基本不成立。
② 合批之后,拆件只比序列帧慢 1.4 ~ 2 倍
| 同屏 | 合批 · 拆件 | 合批 · 序列帧 | 差距 |
|---|---|---|---|
| 30 | 0.62 ms | 0.43 ms | 1.46× |
| 60 | 0.58 ms | 0.40 ms | 1.44× |
| 120 | 0.89 ms | 0.45 ms | 1.99× |
差距来自顶点数(拆件 24n 个顶点 vs 序列帧 6n),不是 draw call。 在 60fps 的 16.7ms 预算里,这点差距完全不是瓶颈。
③ 所以真正的决定性因素不是帧率,是内存
| 纹理内存 | 磁盘体积 | |
|---|---|---|
| 拆件(4 种动物全尺寸零件) | 1.58 MB | 698 KB |
| 序列帧(按 48px 烘焙) | 540 KB | 10 KB |
同一套动作,按 48px 烘焙出来长这样(左上角标了实际像素尺寸,右边是放大 6 倍的样子):
放大 6 倍看细节还在不在:
同屏几十个相同物体,序列帧(烘焙)更好——但好处主要来自内存和包体,不是帧率。
帧率上合批后只差 1.4~2 倍(30 只时 0.62ms vs 0.43ms,都远在预算内); 内存上差 2.9 倍,包体上差 70 倍——而包体对小游戏是硬指标。
另外序列帧还多一个拆件没有的优势:所有实例完全相同 → 可以用 GPU 实例化, 一个 draw call 画完 30 只(实测 30 只时 0.75ms vs 序列帧普通绘制 0.79ms, 在软件渲染下差别不大,但在真实 GPU 上实例化的收益会更明显)。
7.4 但如果是 Canvas 2D,序列帧是压倒性的#
微信小游戏两种后端都支持。Canvas 2D 下没有任何合批,每次 drawImage 都是独立开销:
| 同屏 | 拆件 | 序列帧 | 差距 |
|---|---|---|---|
| 30 | 1.55 ms | 0.32 ms | 4.8× |
| 120 | 6.02 ms | 1.56 ms | 3.9× |
120 只时拆件要吃掉 6ms,是 16.7ms 预算的 36%——这时候就必须上烘焙了。
同屏同类物体越多,就越应该把动画"烘焙"成序列帧。 这不只适用于角色:粒子、飘字、金币特效,凡是"同一个东西重复几十次"的,都是这个规律。
七、同屏上千上万:瓶颈会转移#
几十个和几万个是两个完全不同的问题。数量上去以后,第三节和第六节讨论的东西全部不再是瓶颈。
8.1 结论先行#
| 数量级 | 瓶颈是什么 | 关键手段 |
|---|---|---|
| 几十只 | draw call 数量、包体大小 | 合批 / 烘焙 |
| 几百只 | 还是 draw call | 实例化 |
| 上千~上万 | 像素填充率(fillrate) | 缩小尺寸、剔除、降帧率 |
实测:同样画 2.88 M 像素, 20000 只 × 12px = 486 ms,而 1250 只 × 48px 只要 72 ms。
同样多的像素、同样一次 draw call,差 6.8 倍——所以"物体数"本身也是成本, 但像素数的系数大得多。优化要往"让每个东西占更少像素"上使劲。
8.2 业界在用的方案#
| 方案 | 做法 | 适用 | 资料 |
|---|---|---|---|
| 实例化(GPU Instancing) | 一份几何 + 每实例属性,1 次 draw call 画完 | 上万个相同物体 | Khronos WebGL 技术分享 |
| 单次批绘制(Single-draw Batching) | 所有四边形拼进一个顶点缓冲 | 数量中等,几何简单 | VectoriumEngine:60fps @ 60 万实体 |
| 顶点着色器驱动动画 | 帧号由 uTime 在顶点着色器里算,buffer 一次上传不再改 |
本文采用 | — |
| 顶点动画纹理(VAT) | 把每帧顶点位置烘进贴图,顶点着色器采样 | 3D / 有骨骼形变的角色 | Babylon.js VAT 文档、Unity GPU 动画教程 |
| GPU 精灵层 | 引擎层封装:一块 buffer 装几万个精灵 | 引擎已内置,直接用 | Phaser 4 SpriteGPULayer |
对2D 精灵来说,VAT 是多余的——精灵本来就是一张四边形,把 16 帧打在图集里、 用实例化 + 顶点着色器算 UV 偏移,就等价于 VAT 干的事,而且更简单。
8.3 实测:成本模型#
在 1024×768 视口下测了 12 组(数量 × 尺寸),线性拟合:
每帧耗时(ms) ≈ 0.0221 × 实例数 + 14.8 × 百万像素残差最大 4.5 ms / 486 ms,拟合得很准:
| 场景 | 像素数 | 实测 | 拟合 |
|---|---|---|---|
| 20000 只 × 12px | 2.88 M | 486.6 ms | 485.0 |
| 5000 只 × 24px | 2.88 M | 152.2 ms | 153.2 |
| 1250 只 × 48px | 2.88 M | 72.0 ms | 70.3 |
| 10000 只 × 24px | 5.76 M | 306.8 ms | 306.4 |
| 20000 只 × 24px | 11.52 M | 611.6 ms | 612.9 |
14.8 ms/百万像素 是填充率成本——真实 GPU 上同样存在,只是常数小得多
(手机 GPU 参考填充率 14 Gpixel/s,11.5 M px 约 311 ms)。
0.0221 ms/实例 是每实例的图元装配开销——测试机没有 GPU,数字来自 SwiftShader 软件光栅化,这个系数被极度放大,真实 GPU 上小几个数量级。 结论方向可信,绝对值不可信。 真机数字必须自己在目标设备上重测。
8.4 怎么实现:帧号交给顶点着色器算#
这是上万规模下最有用的一招。要点是每帧只更新一个 uniform,不动顶点缓冲:
// 每实例属性:iD = (x, y, phase, scale),iUVStep = (1/列数, 1/行数)
attribute vec2 aPos;      // 四边形角点 0..1
attribute vec4 iD;
attribute vec2 iUVStep;

uniform float uTime;      // 秒
uniform float uFPS;
uniform float uFrames;    // 总帧数
uniform vec2  uGrid;      // (列数, 行数)

varying vec2 vUV;

void main() {
  // ★ 帧号在 GPU 上算,CPU 每帧只需要 gl.uniform1f(uTime, t)
  float fi = floor(mod(uTime * uFPS + iD.z, uFrames));
  float cx = mod(fi, uGrid.x);
  float cy = floor(fi / uGrid.x);

  vUV = vec2(cx, cy) * iUVStep + aPos * iUVStep;
  vec2 world = iD.xy + aPos * iD.w;         // iD.z 是相位,让每只错开
  gl_Position = vec4(world / uResolution * 2.0 - 1.0, 0.0, 1.0);
}实例缓冲的构造(只做一次):
const d = new Float32Array(n * 6);
for (let i = 0; i < n; i++) {
  const o = i * 6;
  d[o]     = x[i];          // 位置
  d[o + 1] = y[i];
  d[o + 2] = (i * 3) % 16;  // 相位:错开播放,否则上万个动作完全同步会很假
  d[o + 3] = size;          // 尺寸
  d[o + 4] = 1 / cols;      // 每帧在 UV 上的步进
  d[o + 5] = 1 / rows;
}
gl.bufferData(gl.ARRAY_BUFFER, d, gl.STATIC_DRAW);   // ← 一次
// 之后每帧只有:
gl.uniform1f(uTimeLoc, t);
gl.drawArraysInstanced(gl.TRIANGLES, 0, 6, n);上万个物体如果帧号完全同步,看起来像一块巨大的抽搐的色块。
iD.z 存一个每实例不同的相位,在着色器里加进去——零额外成本。
8.5 CPU 侧根本不用担心#
单独量了纯 JS 侧(硬件无关):
| 同屏数量 | 每帧重建整个 buffer | 只改帧号字段 | 上传量/帧 |
|---|---|---|---|
| 1000 | 0.048 ms | 0.016 ms | 23 KB |
| 10000 | 0.094 ms | 0.034 ms | 234 KB |
| 100000 | 0.810 ms | 0.240 ms | 2.34 MB |
十万个物体重建整个 buffer 也只要 0.81 ms。 所以"每帧重建 buffer 太贵"是个伪命题—— 真正该省的是别的地方。不过既然静态 buffer 更简单(少写代码),就用静态的。
8.6 优化清单(按收益排序)#
| 优先级 | 手段 | 收益 | 代价 |
|---|---|---|---|
| ★★★ | 缩小显示尺寸 / LOD | 填充率 ∝ 尺寸²,减半就是省 4 倍 | 画面变小 |
| ★★★ | 视口剔除 | 屏幕外的一个像素都不画 | 要维护空间索引 |
| ★★☆ | 实例化 | draw call 降到 1 | 需要 WebGL2 或 ANGLE_instanced_arrays |
| ★★☆ | 降帧率 | 背景物体 6~12fps 就够,成本按比例降 | 动画略顿 |
| ★☆☆ | 静态 buffer + 着色器算帧 | 省掉每帧上传 | 实现稍复杂 |
| ★☆☆ | 图集 / 贴图数组 | 避免纹理切换 | 打包工序 |
微信小游戏的渲染层支持 WebGL2
(官方说明),
但为了兼容老设备通常还是按 WebGL1 写,实例化走 ANGLE_instanced_arrays 扩展。
drawArraysInstanced 在 WebGL1 下要写成 ext.drawArraysInstancedANGLE——
本文的测试脚本两种都做了兼容。
8.7 这套用在小农场上意味着什么#
我们的场景是"田里几百株作物 + 几十只动物",远没到上万的量级。 第六节的结论不变(烘焙序列帧)。但有两个可以现在就做的:
- 作物如果要做几百株摇摆,用实例化 + 着色器算相位,成本几乎为零
(摇摆不需要美术,
sin(uTime + phase)直接改顶点就行)。 - 飘字 / 金币 / 粒子这类"同一张图重复几百次"的东西,直接按本章的实例化写法做。
八、本项目的决定#
| 场合 | 用什么 | 理由 |
|---|---|---|
| 所有角色动画的制作 | 拆件(tools/art/waddle.py 这类 rig) |
可调、好迭代,改一个数字就能看效果 |
| 主界面那只(点它加钱的那只) | 直接跑骨骼 | 屏幕上就 1~2 只,开销无所谓,而且要能实时响应点击 |
| 田里 / 街上几十只 | 从拆件烘焙成序列帧,--bake 48 |
纹理内存省 2.9 倍、包体省 70 倍;Canvas 2D 下还快 4 倍 |
| 金色小鸡出现 / 大丰收这种"演出时刻" | 可以上序列帧或加特效 | 出现频率低、时间短,值得多花一点体积换表现力 |
| 交互反馈 / 飘字 / 粒子 / 待机摆动 | 代码做,零素材 | 见 docs/动效验证-序列帧.md 第四节 |
下一步:
- 把四个动物从原图切零件(小兔的长耳朵、小猪的卷尾巴会有更明显的次级运动)。
-
给—— 已完成,用法是waddle.py加一个--bake-size参数--bake 48。 - 下一批角色出图时,按第五节那张表分层出图,不要再画成"一坨"。
- 用同一套基准脚本,量一下真机(微信开发者工具 / 真机)上的数字。 测试机没有 GPU,第七节那些绝对值来自软件光栅化,只能看趋势。
- 给作物摇摆做一版实例化 + 着色器算相位的实现(几百株的成本几乎为零)。
docs/动效验证-序列帧.md—— 三种做法的实测过程与数据docs/美术风格.md—— 画风基准与可执行验收标准